Funciones de agrupación
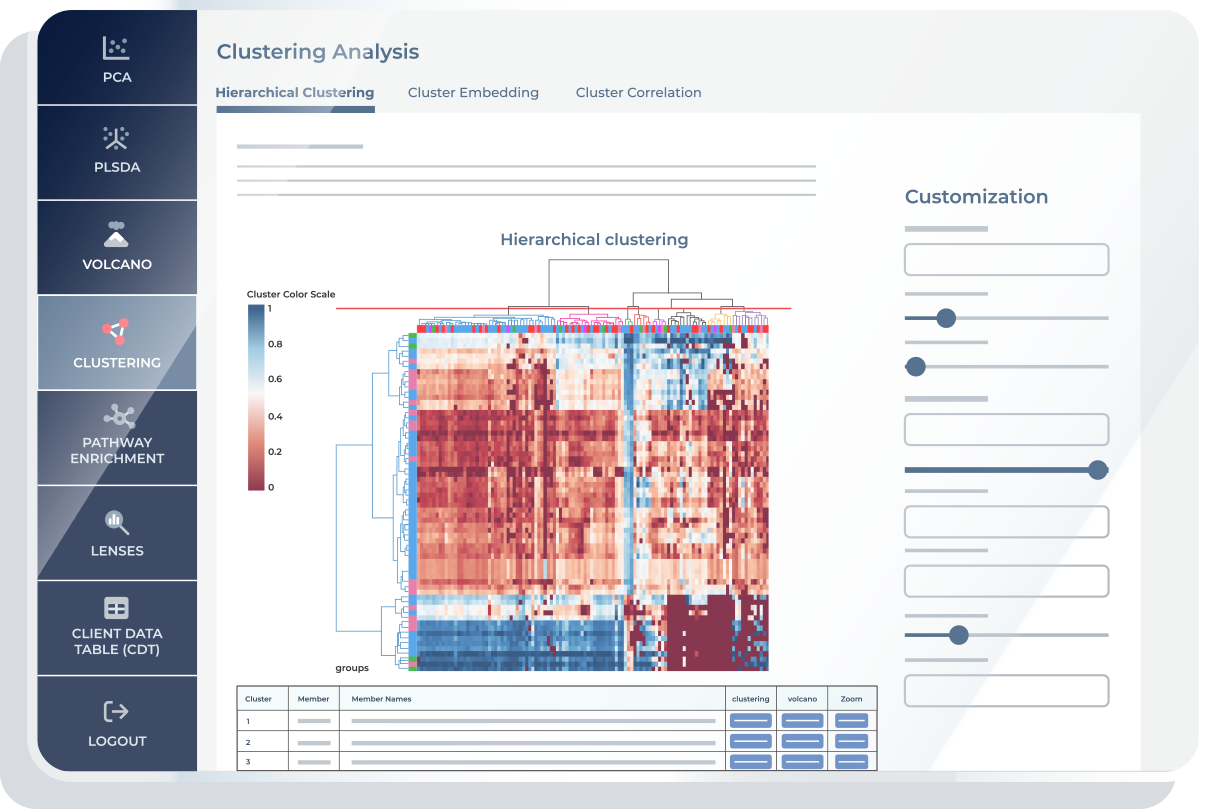
La agrupación jerárquica en nuestra plataforma permite agrupar tanto metabolitos como muestras. El clustering jerárquico es un método de análisis de clusters que identifica relaciones entre los elementos (metabolitos o muestras) en los clusters. Esta doble funcionalidad es importante para analizar diferentes aspectos de los datos metabolómicos. Dependiendo de lo que se elija para el análisis, el mapa de calor muestra las intensidades de metabolitos o muestras. La agrupación de metabolitos puede revelar patrones en las relaciones y vías bioquímicas, mientras que la agrupación de muestras puede ayudar a comprender las variaciones entre diferentes condiciones o fenotipos.
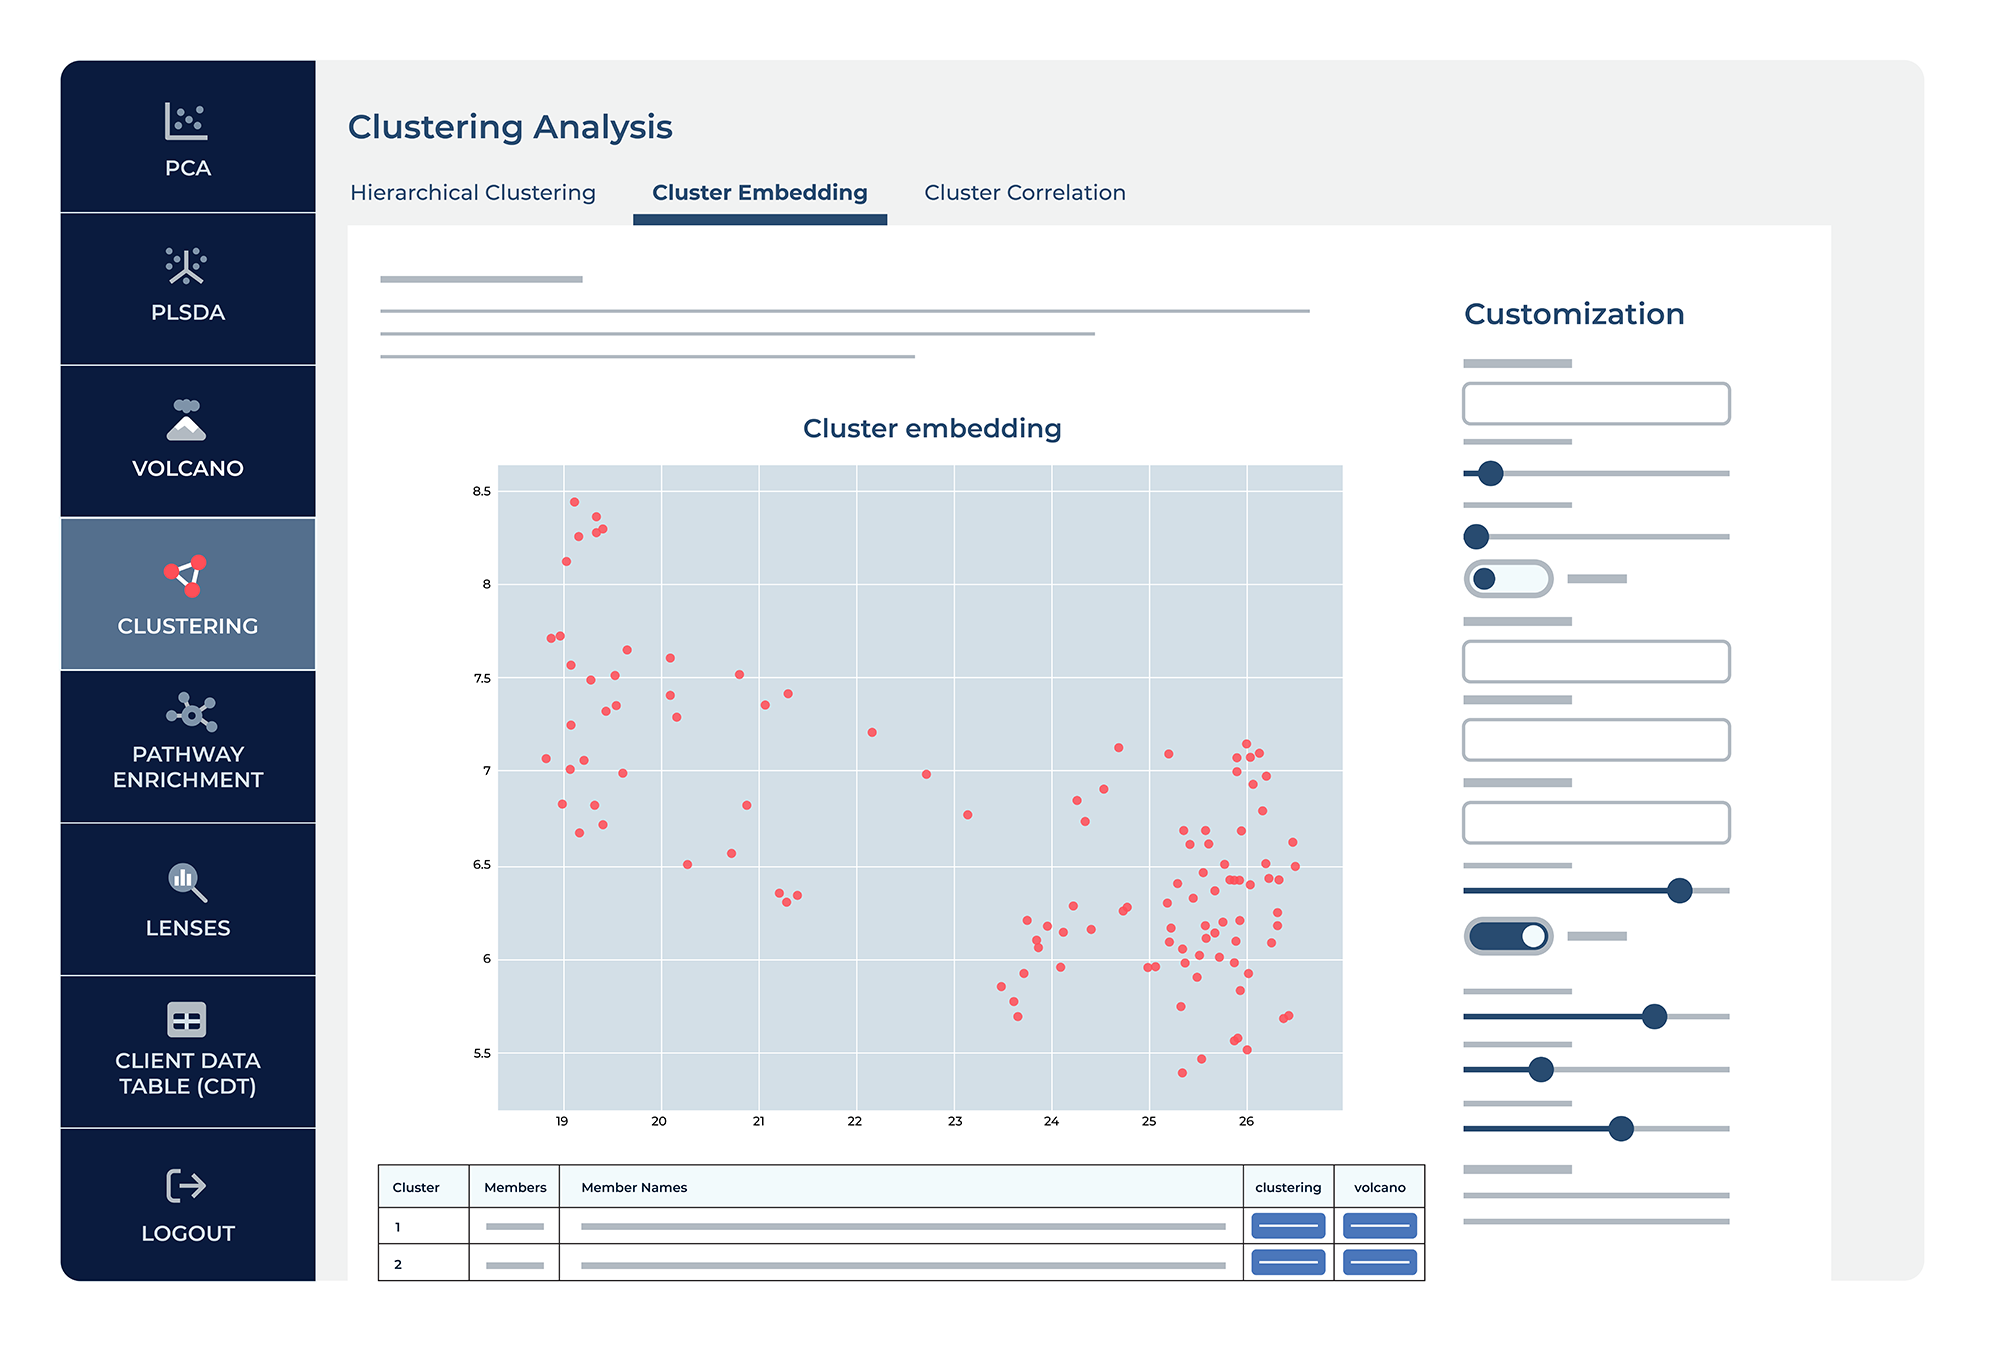
La incrustación es el proceso de representar algo en un ordenador. La incrustación de conglomerados es una técnica que reduce la dimensionalidad de los datos. Al convertir los datos metabolómicos en números que el ordenador puede analizar, se reduce la complejidad de los datos. A diferencia de la agrupación jerárquica, la incrustación se centra en representar los datos de una forma que pueda revelar patrones no observables inmediatamente en el conjunto de datos en bruto, revelando potencialmente subtipos dentro de afecciones o enfermedades. Este enfoque es especialmente ventajoso en metabolómica, donde la naturaleza altamente dimensional de los datos puede ocultar patrones subyacentes cuando se ven en su forma bruta.
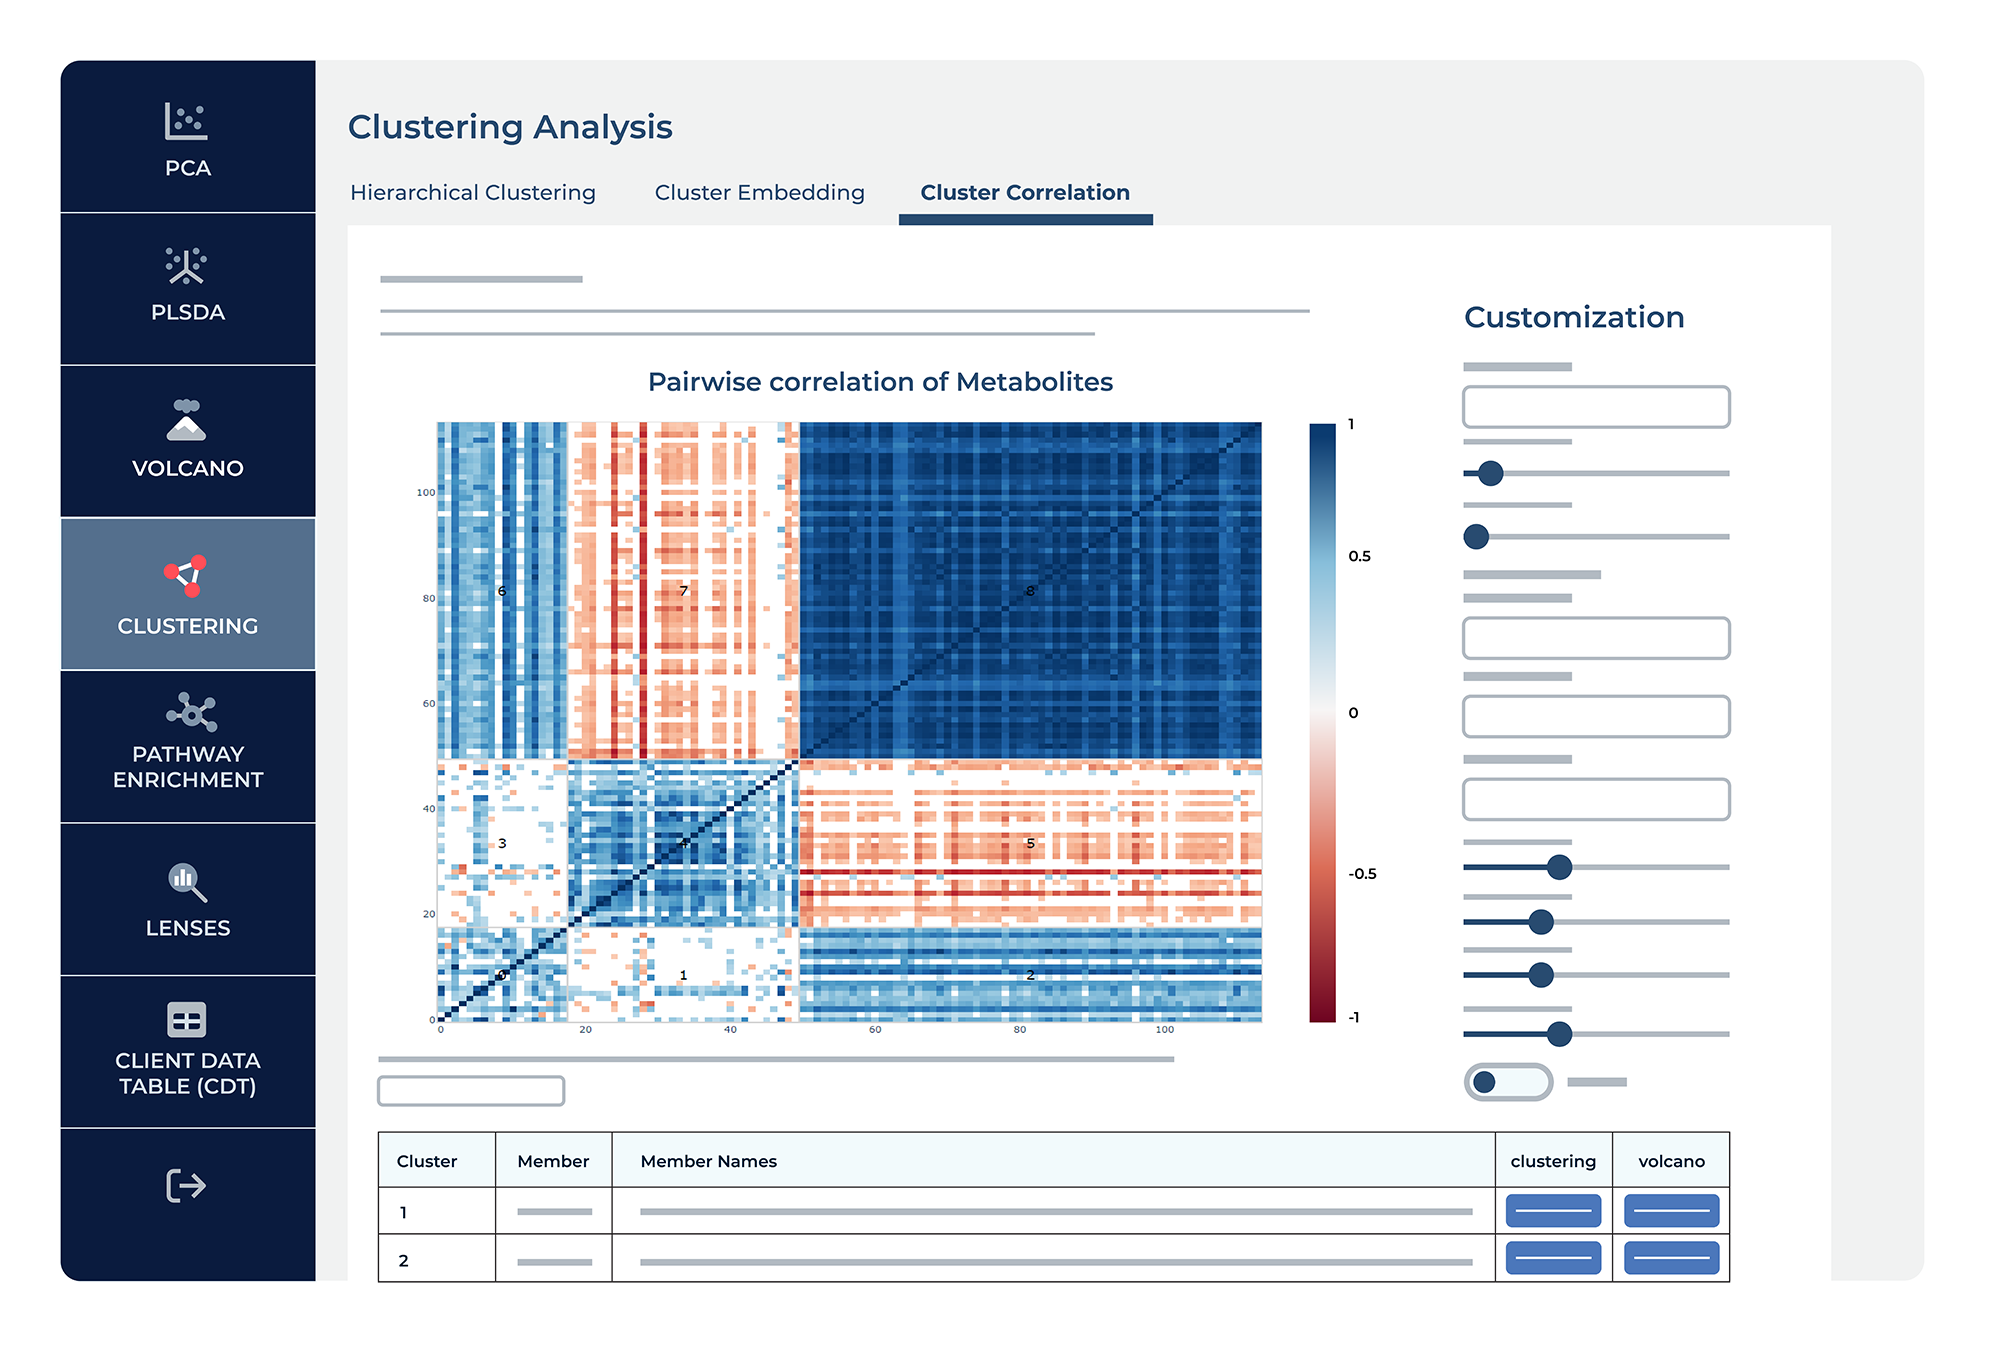
La función de correlación de clústeres de la plataforma bioinformática de Metabolonamplía el análisis de clústeres incorporando métricas de correlación para evaluar las relaciones entre metabolitos o muestras. Esta característica es vital para identificar la co-regulación y las interacciones potenciales dentro de los datos metabolómicos.
Inicialmente, la herramienta calcula una matriz de correlación por pares, evaluando el grado de variación entre metabolitos o muestras en diferentes condiciones. Este paso es fundamental, ya que cuantifica la fuerza y la dirección de las relaciones. Tras el análisis de correlación, se aplica el algoritmo de biagrupamiento espectral¹. Esta técnica está diseñada para agrupar simultáneamente filas y columnas, identificando así bloques homogéneos dentro de la matriz: grupos de metabolitos o muestras con patrones de correlación similares.
Al visualizar los resultados, se puede interactuar con la matriz de correlación, ajustando parámetros como el umbral del coeficiente de correlación para refinar la granularidad de los bi-clusters. Las herramientas visuales incluyen mapas de calor que proporcionan una forma intuitiva de interpretar los datos de correlación. Los biclústeres resultantes también se superponen al mapa de calor para determinar fácilmente qué puntos de la matriz de correlación pertenecen a cada clúster.
Visión general del análisis clustering
Arroje luz sobre las intrincadas relaciones entre muestras o metabolitos revelando cómo se interrelacionan los grupos de muestras o metabolitos. Nuestra herramienta de análisis de agrupación identifica de forma inteligente los parámetros de agrupación óptimos, haciendo que el análisis sea más accesible.
La agrupación es un método básico en el campo del análisis de datos y la bioinformática, que se utiliza para agrupar entidades en función de sus similitudes. Esta técnica es crucial para revelar las estructuras inherentes a los datos, lo que a menudo conduce a descubrimientos reveladores en diversos ámbitos científicos. Comprender los matices de la agrupación puede mejorar significativamente su comprensión de los patrones y relaciones ocultos de sus datos.
Análisis de agrupamiento dentro Metabolon Plataforma Bioinformática Integrada de
En metabolómica, la agrupación es un potente método utilizado para organizar tanto los metabolitos como las muestras en grupos significativos. Reduce la complejidad y guía la investigación centrada en hipótesis, ofreciendo una visión más clara del paisaje metabólico y sus implicaciones para la salud y la enfermedad.
Pathway Insights
Los metabolitos que se agrupan suelen participar en las mismas rutas metabólicas o en otras relacionadas. Al observar qué metabolitos se agrupan, los investigadores pueden deducir su participación en procesos bioquímicos comunes. Por ejemplo, si un grupo de aminoácidos se agrupa, podría indicar su papel colectivo en las vías de síntesis o degradación de proteínas.
Descubrimiento de biomarcadores
Los grupos de metabolitos que se agrupan en condiciones específicas podrían ser biomarcadores potenciales que ayuden a comprender y tratar las enfermedades.
Hypothesis Generation
Los conglomerados pueden dar lugar a hipótesis sobre procesos biológicos que orienten la investigación. Además, las muestras también pueden agruparse para su posterior análisis.
Phenotype Characterization
Agrupar muestras relacionadas en función de perfiles metabólicos puede ayudar a distinguir fenotipos o afecciones.
Response Patterns
La agrupación de muestras ayuda a identificar patrones comunes de respuesta a tratamientos o cambios ambientales, lo que permite comprender mejor la dinámica del sistema.
Una experiencia fácil de usar
- Variety of Clustering Algorithms
Access a range of algorithms including K-means, hierarchical, and DBSCAN, each suited for different types of data and research questions. - Interactive Visualizations
Dynamic and interactive visualizations allow you to explore the clusters and their characteristics, thereby enhancing understanding and interpretation. - Integration with Other Analyses
Seamless integration with other tools in the platform, such as volcano analysis, allows you to explore the resulting clusters with other analytical approaches.
Referencias
1. Kluger, Yuval, et al. "Spectral biclustering of microarray data: coclustering genes and conditions". Investigación del genoma 13.4 (2003): 703-716.
