Caractéristiques de regroupement
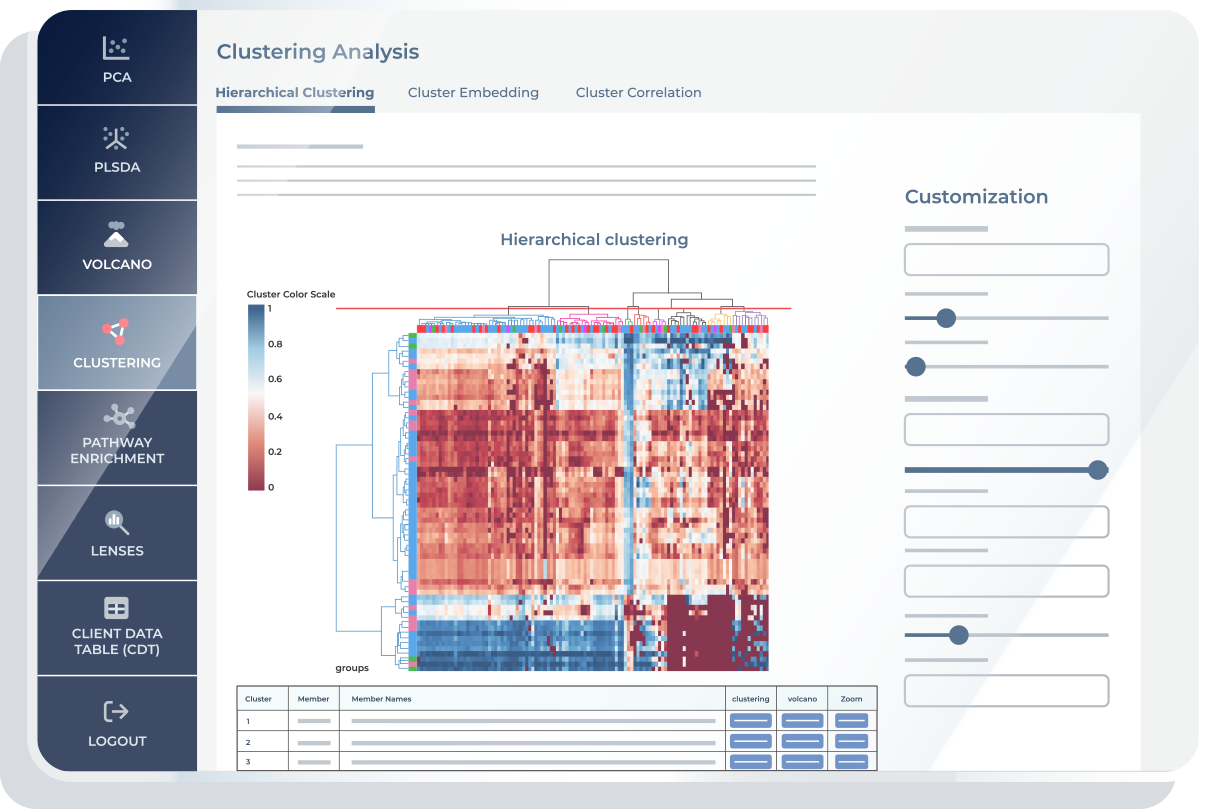
Dans notre plateforme, le clustering hiérarchique permet de regrouper à la fois les métabolites et les échantillons. Le clustering hiérarchique est une méthode d'analyse de clusters qui identifie les relations entre les éléments (métabolites ou échantillons) dans les clusters. Cette double fonctionnalité est importante pour analyser différents aspects des données métabolomiques. Selon l'élément choisi pour l'analyse, la carte thermique affiche les intensités des métabolites ou des échantillons. Le regroupement des métabolites peut révéler des schémas dans les relations biochimiques et les voies, tandis que le regroupement des échantillons peut aider à comprendre les variations entre différentes conditions ou phénotypes.
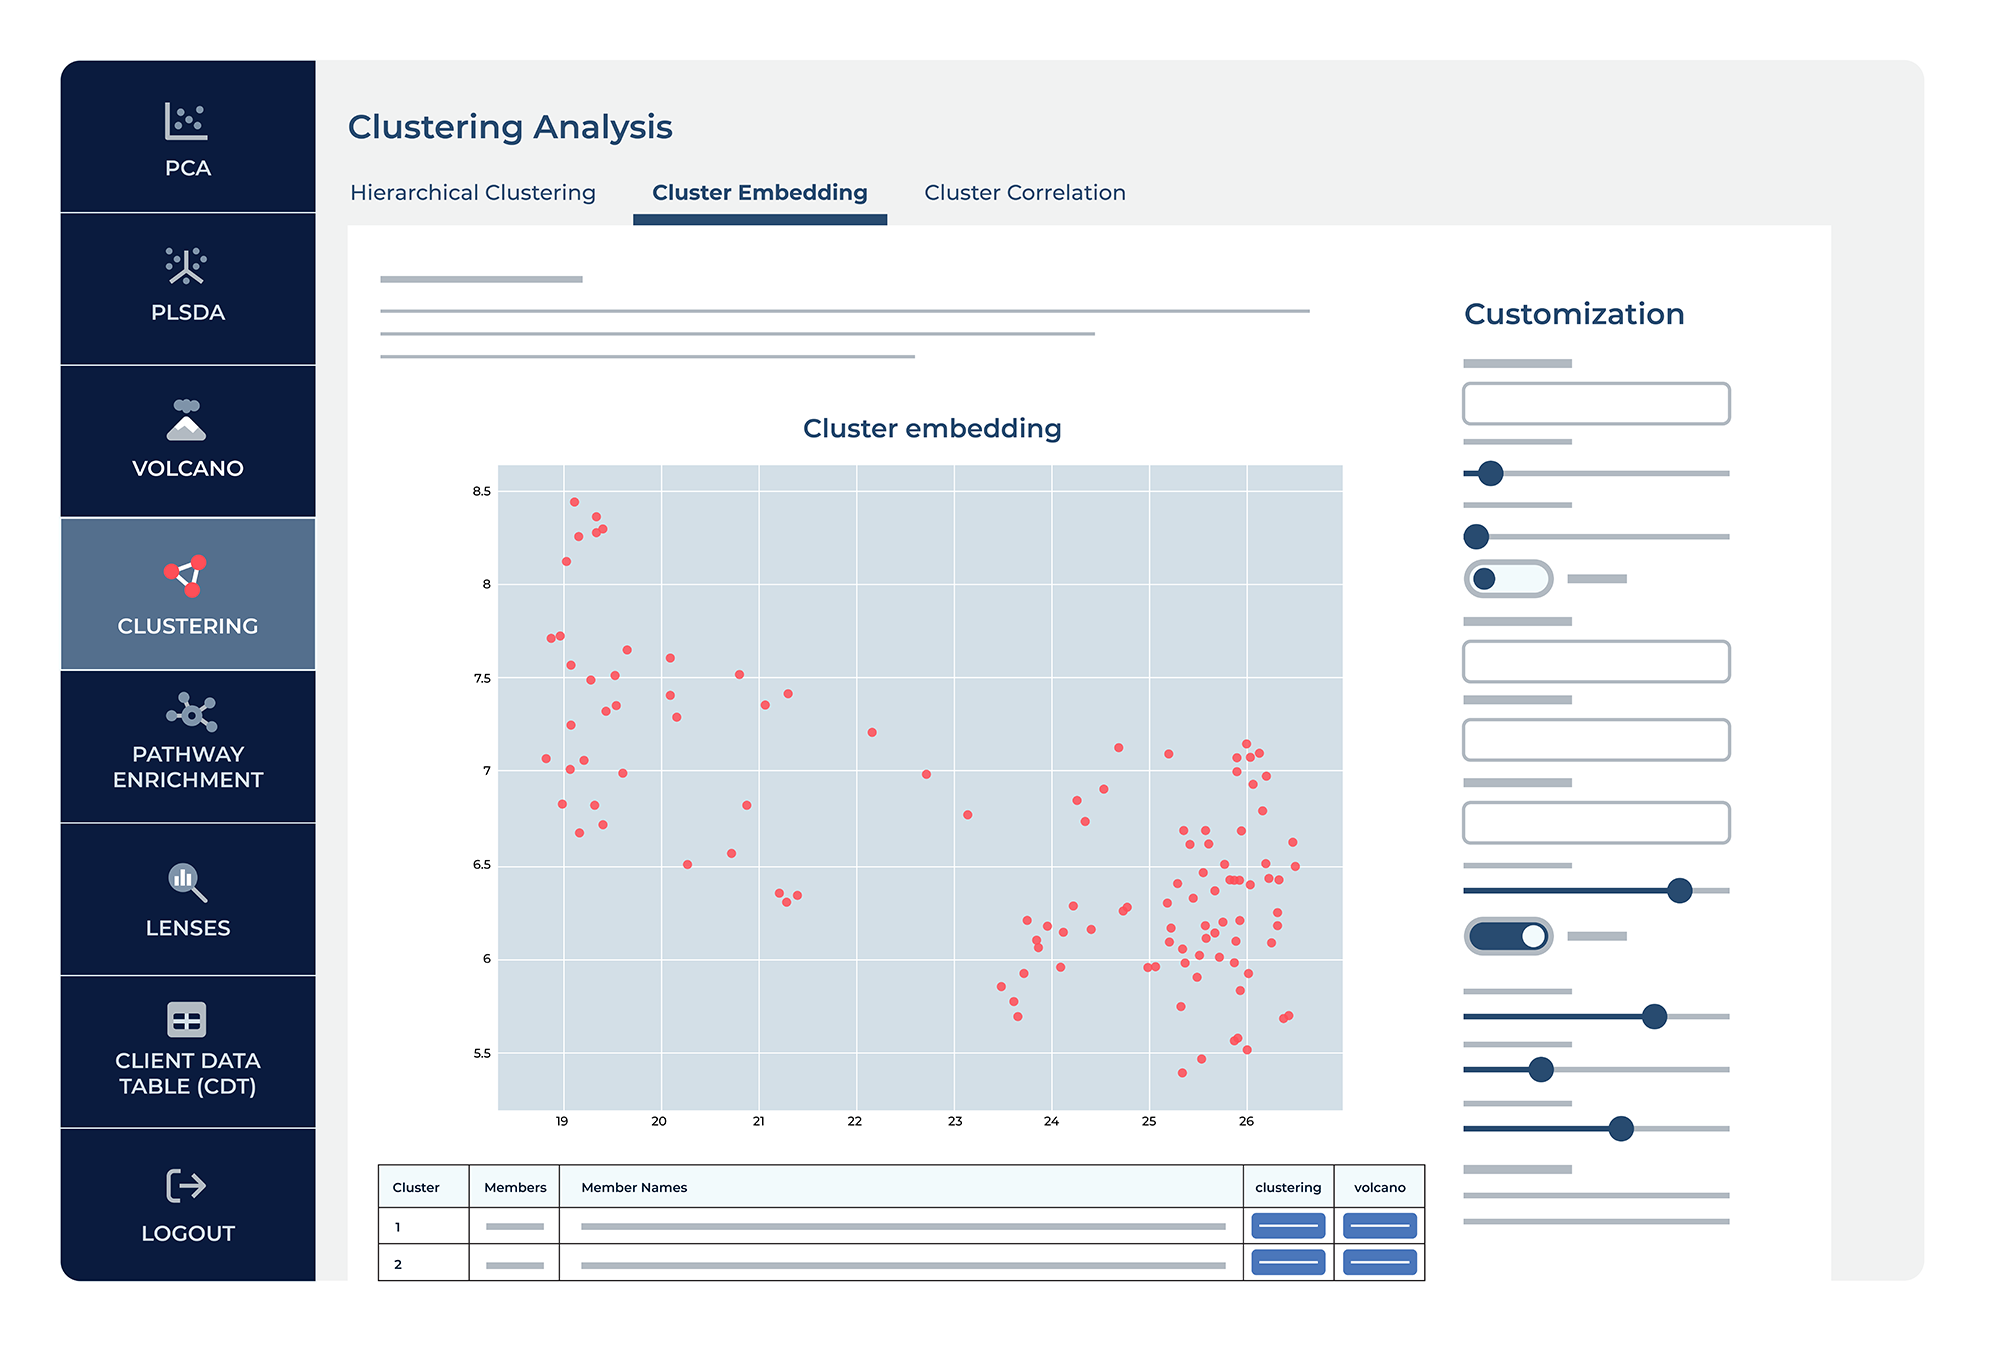
L'intégration est le processus qui consiste à représenter quelque chose dans un ordinateur. L'intégration de grappes est une technique qui réduit la dimensionnalité des données. En convertissant les données métabolomiques en nombres que l'ordinateur peut analyser, la complexité des données est réduite. Contrairement au regroupement hiérarchique, l'incorporation se concentre sur la représentation des données d'une manière qui peut révéler des modèles qui ne sont pas immédiatement observables dans l'ensemble de données brutes, révélant potentiellement des sous-types au sein des conditions ou des maladies. Cette approche est particulièrement avantageuse en métabolomique, où la nature hautement dimensionnelle des données peut masquer les schémas sous-jacents lorsqu'elles sont examinées sous leur forme brute.
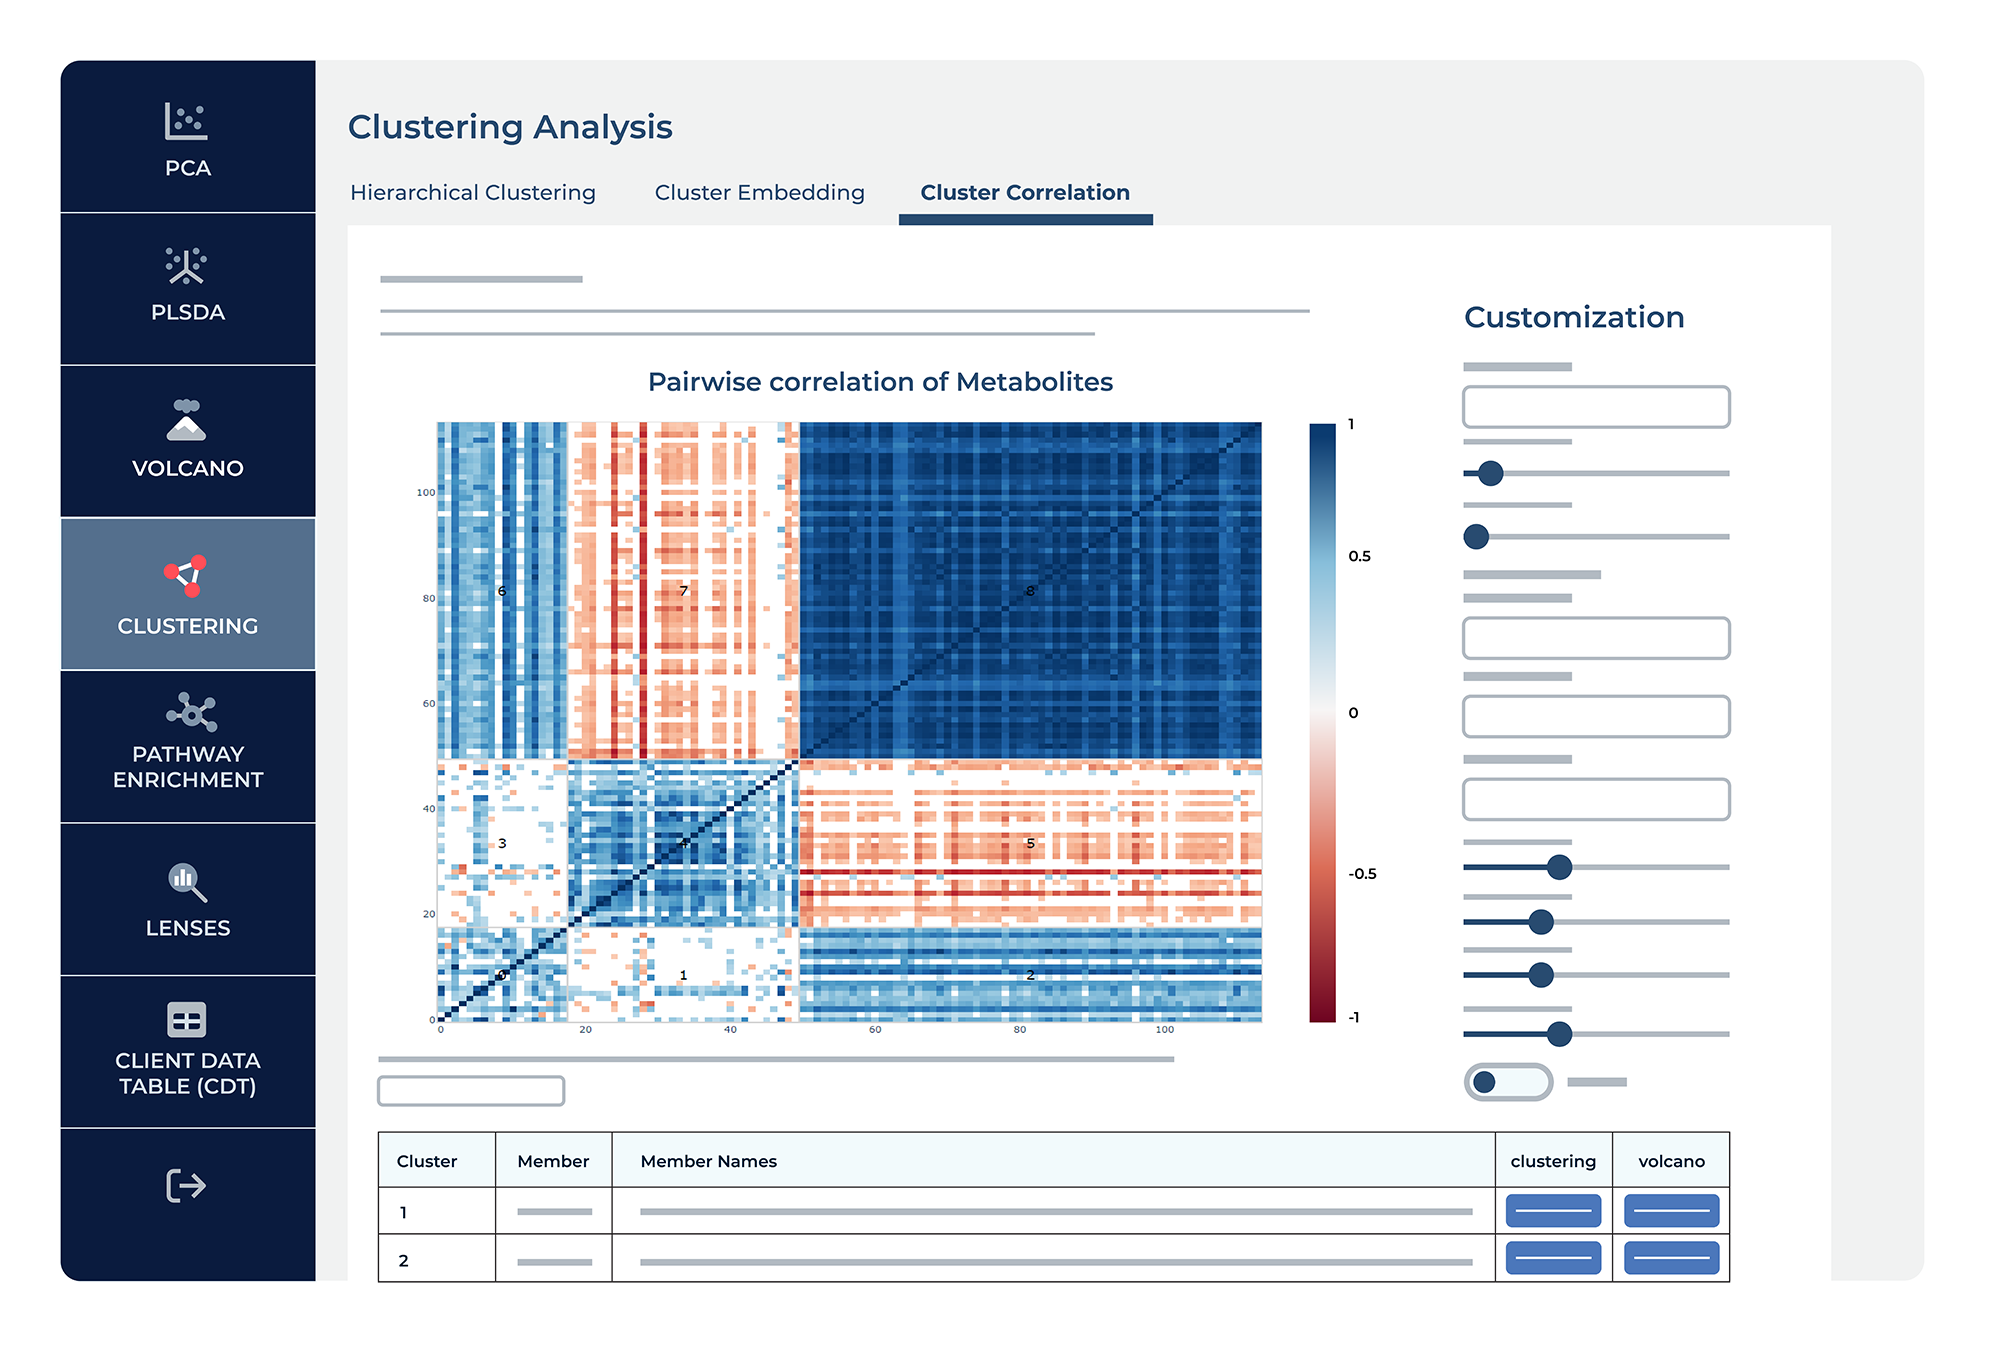
La fonction de corrélation de cluster de la plateforme bioinformatique de Metabolonétend l'analyse de clustering en incorporant des métriques de corrélation pour évaluer les relations entre les métabolites ou les échantillons. Cette fonction est essentielle pour identifier la corégulation et les interactions potentielles dans les données métabolomiques.
Dans un premier temps, l'outil calcule une matrice de corrélation par paire, évaluant la mesure dans laquelle les métabolites ou les échantillons varient ensemble dans différentes conditions. Cette étape est fondamentale car elle quantifie la force et la direction des relations. Après l'analyse de corrélation, l'algorithme de bi-groupage spectral1 est appliqué. Cette technique est conçue pour regrouper simultanément les lignes et les colonnes, identifiant ainsi des blocs homogènes au sein de la matrice - des groupes de métabolites ou d'échantillons présentant des schémas de corrélation similaires.
Lors de la visualisation des résultats, vous pouvez interagir avec la matrice de corrélation, en ajustant des paramètres tels que le seuil du coefficient de corrélation pour affiner la granularité des bi-clusters. Les outils visuels comprennent des cartes thermiques qui offrent un moyen intuitif d'interpréter les données de corrélation. Les bi-clusters résultants sont également superposés à la carte thermique afin de déterminer facilement quels points de la matrice de corrélation appartiennent à quel cluster.
Vue d'ensemble de l'analyse de regroupement
Mettez en lumière les relations complexes entre les échantillons ou les métabolites en révélant comment les groupes d'échantillons ou de métabolites sont liés entre eux. Notre outil d'analyse de regroupement identifie intelligemment les paramètres de regroupement optimaux, ce qui rend l'analyse plus accessible.
Le clustering est une méthode de base dans le domaine de l'analyse des données et de la bio-informatique, utilisée pour regrouper des entités sur la base de leurs similitudes. Cette technique est essentielle pour révéler les structures inhérentes aux données, ce qui permet souvent de faire des découvertes intéressantes dans divers domaines scientifiques. Comprendre les nuances du clustering peut considérablement améliorer votre compréhension des modèles et relations cachés de vos données.
Analyse de regroupement au sein de la plateforme bioinformatique intégrée de Metabolon
En métabolomique, le regroupement est une méthode puissante utilisée pour organiser les métabolites et les échantillons en groupes significatifs. Elle réduit la complexité et guide la recherche ciblée et fondée sur des hypothèses, offrant une vision plus claire du paysage métabolique et de ses implications pour la santé et la maladie.
Pathway Insights
Metabolites that are clustered together often participate in the same or related metabolic pathways. By observing which metabolites co-cluster, researchers can infer their involvement in common biochemical processes. For instance, if a group of amino acids clusters together, it might indicate their collective role in protein synthesis or degradation pathways.
Découverte de biomarqueurs
Groups of metabolites that cluster in specific conditions might be potential biomarkers, aiding in disease understanding and treatment.
Hypothesis Generation
Clusters can prompt hypotheses about biological processes, guiding further targeted research. In addition, samples can also be clustered for further analysis.
Phenotype Characterization
Grouping related samples based on metabolic profiles can help distinguish phenotypes or conditions.
Response Patterns
Clustering samples helps identify common response patterns to treatments or environmental changes, providing insights into system dynamics.
Une expérience conviviale
- Variety of Clustering Algorithms
Access a range of algorithms including K-means, hierarchical, and DBSCAN, each suited for different types of data and research questions. - Interactive Visualizations
Dynamic and interactive visualizations allow you to explore the clusters and their characteristics, thereby enhancing understanding and interpretation. - Integration with Other Analyses
Seamless integration with other tools in the platform, such as volcano analysis, allows you to explore the resulting clusters with other analytical approaches.
Références
1. Kluger, Yuval, et al. "Spectral biclustering of microarray data : coclustering genes and conditions". Genome research 13.4 (2003) : 703-716.
